데이터 기반 의사결정(Data-driven Decision Making)은 이제 기업 경쟁력을 좌우하는 핵심 요소가 되었습니다. 그러나 아이러니하게도, 기업의 데이터 관련 과제는 더욱 복잡해지고 있습니다.
오늘날 비즈니스 환경에서 데이터 기반 의사결정 체계 구축은 정량적 가치 창출을 위한 필수 조건입니다.
하지만 많은 기업은 여전히 구조적인 비효율에 직면해 있습니다. 기업 규모가 커지고 데이터 유형이 다양해질수록, 데이터 분석 프로세스는 오히려 복잡성과 운영 부담이 증가하는 양상을 보입니다. 데이터는 여러 시스템에 분산되어 있고, 분석 도구 간 연계는 제한적이며, 중앙 집중형 거버넌스 체계 또한 충분히 갖춰지지 않은 경우가 많습니다. 그 결과 투입되는 비용과 리소스 대비 인사이트 도출 속도가 비즈니스 성장 속도를 따라가지 못하는 문제가 발생합니다. 이는 현재 많은 기업이 겪고 있는 ‘데이터 인프라의 기술 부채(Technical Debt)’라고 할 수 있습니다.
Microsoft Fabric은 이러한 구조적 병목을 해소하기 위해 설계된 통합 분석 플랫폼입니다. 데이터 수집부터 저장, 분석, AI 활용, 시각화에 이르는 전 과정을 하나의 통합된 파이프라인으로 연결함으로써 운영 효율성과 데이터 활용 생산성을 극대화합니다.
이번 포스트에서는 Microsoft Fabric의 아키텍처와 실제 UI를 중심으로, 기업이 직면한 데이터 사일로와 비용 비효율 문제를 어떻게 해결할 수 있는지 살펴봅니다. 더 나아가, 데이터 중심 조직으로 전환하기 위한 실질적인 혁신 방향과 운영 전략을 함께 제시하고자 합니다.

‘Microsoft Fabric’이란 무엇인가요?

Microsoft Fabric은 데이터 수집, 변환, 실시간 스트리밍 처리, 머신러닝 분석, 비즈니스 인텔리전스(BI) 리포팅까지 전 과정을 하나의 환경에서 통합 제공하는 SaaS(Software as a Service) 기반의 차세대 데이터 분석 플랫폼입니다. 기존의 데이터 아키텍처 환경에서는 데이터 저장소, ETL 도구, 분석 엔진, 시각화 솔루션을 각각 별도로 구축하고 연동해야 했습니다. 또한 네트워크 구성, 권한 관리, 보안 정책 설정 등 복잡한 인프라 운영 부담이 지속적으로 발생했습니다.
반면, Microsoft Fabric은 완전 관리형 SaaS 플랫폼으로 제공되기 때문에 기업은 인프라 구축과 운영에 드는 부담을 줄이고 데이터 분석과 비즈니스 가치 창출에 더욱 집중할 수 있습니다. 특히 데이터 엔지니어, 데이터 과학자, BI 분석가, 현업 부서가 하나의 통합된 환경에서 협업할 수 있도록 설계되어 조직 전체의 데이터 활용 생산성과 의사결정 속도를 높이는데 강점을 가지고 있습니다.
| 핵심 키워드로 이해하는 ‘Microsoft Fabric’
1. OneLake(데이터를 위한 OneDrive)
OneLake는 Microsoft Fabric의 핵심 저장 계층으로, 모든 워크로드가 하나의 중앙 집중형 논리 데이터 레이크를 공유하는 구조입니다. 기존 환경에서는 데이터 분석 목적에 따라 데이터를 여러 저장소로 반복 복제해야 했지만, Fabric에서는 동일 데이터를 다양한 서비스가 직접 참조할 수 있습니다. 이를 통해 데이터 이동 및 중복 저장 비용을 줄이고, 데이터 일관성과 거버넌스를 강화할 수 있습니다.
2. Copilot 내장
Microsoft Copilot이 플랫폼 전반에 기본 내장되어 있어 자연어 기반으로 다양한 데이터 작업을 수행할 수 있습니다. 이를 통해 전문 개발자뿐 아니라 현업 사용자도 보다 쉽게 데이터 분석 업무에 참여할 수 있으며, 생산성과 업무 속도를 동시에 향상시킬 수 있습니다.
3. 역할 중심 워크스페이스
기존 데이터 플랫폼 환경에서는 엔지니어링, 분석, 시각화 업무가 서로 다른 도구와 인터페이스에서 운영되는 경우가 많았습니다. Microsoft Fabric은 역할 기반 워크스페이스를 제공해 데이터 엔지니어, 데이터 사이언스, BI 분석가, 비즈니스 사용자까지 하나의 플랫폼 안에서 유기적으로 협업할 수 있도록 지원합니다. 그 결과, 부서 간 데이터 단절을 줄이고 프로젝트 운영 효율성과 데이터 활용 일관성을 높일 수 있습니다.
Microsoft Fabric이 왜 강력한지 이해하려면 아키텍처 구조를 살펴보아야 합니다. Fabric은 복잡한 데이터 파이프라인을 유기적으로 결합한 형태를 띠고 있으며 모든 직무의 데이터 담당자가 협업할 수 있도록 정교하게 설계되어 있습니다. 이해를 돕기 위해 구조를 시각화한 이미지를 함께 살펴보겠습니다.
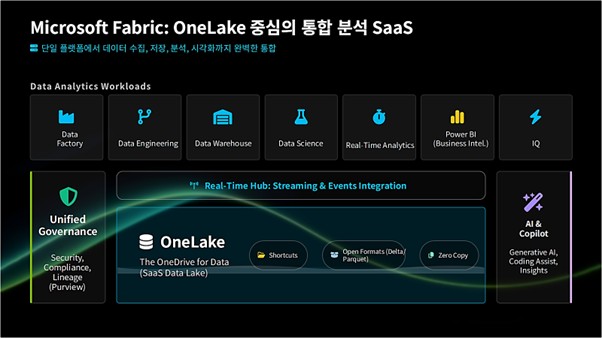 [그림 1] OneLake를 중심으로 모든 분석 워크로드가 통합된 Microsoft Fabric의 핵심 아키텍처 구조
위 아키텍처에서 볼 수 있듯이, Fabric은 크게 세 개의 층으로 나뉩니다.
- 상부(핵심 워크로드) : 데이터 팩토리로 가져와 엔지니어링 툴로 정제하고, Power BI로 시각화하는 엔드 투 엔드 시나리오가 단일 환경에서 매끄럽게 연결됩니다.
- 중부(공유 서비스 계층) : Microsoft Purview 기반의 거버넌스 정책과 Copilot AI가 전반에 적용되어 보안과 생산성을 동시에 잡았습니다.
- 하부(OneLake 스토리지) : 모든 워크로드는 데이터를 복사하지 않고 원래 위치에 둔 채 재사용하는 ‘제로 카피(Zero-Copy)’ 패턴을 구현합니다.
Microsoft Fabric은 데이터 자산을 다루는 모든 임직원이 각자의 업무 방식에 맞춰 최적의 효율을 낼 수 있도록 7가지 전문 워크로드를 제공합니다.
| ① Data Factory : 원클릭으로 연결하는 데이터 수집 및 통합
다양한 데이터 원본 집합에서 데이터를 수집, 준비 및 변환하는 최신 데이터 통합 환경을 제공합니다. 현업에서 널리 쓰이는 파워 쿼리(Power Query)의 단순성을 통합하고, 200개 이상의 네이티브 커넥터를 사용하여 온-프레미스(내부 서버)와 멀티 클라우드의 다양한 데이터 원본에 손쉽게 연결할 수 있습니다.
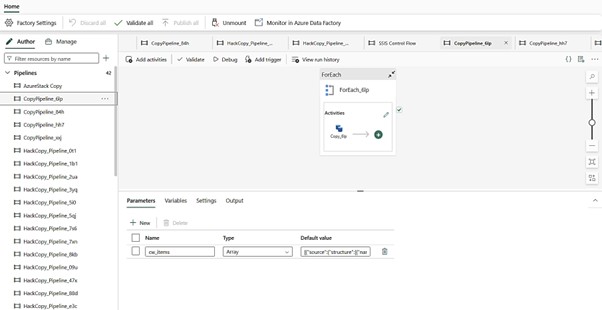 [그림 2] Data Factory의 데이터 파이프라인(Pipelines) 구축 및 워크플로우 오케스트레이션 UI 화면
직관적인 GUI 화면을 통해 복잡한 하드코딩 없이 사내 여러 테이블과 외부 API 데이터를 시각적으로 연결하고, ‘ForEach’ 루프 같은 조건문 액티비티를 통해 전사 데이터 수집 흐름을 시각적으로 제어하고 자동화 주기를 설정하여 손쉽게 스케줄링할 수 있습니다.
| ② 데이터 엔지니어링 : 빅데이터 처리를 위한 고성능 ‘Apache Spark’
데이터 변환 작업을 작성하고 예약하는 Notebook과 도구를 사용하여 대규모 빅데이터 세트를 처리하는 Apache Spark 환경을 제공합니다. 방대한 데이터 볼륨을 수집, 저장, 처리 및 분석하기 위한 인프라를 직접 만들고, 관리하고, 최적화할 수 있습니다. 특히 Fabric Spark와 Data Factory의 긴밀한 통합을 통해 Notebook 및 Spark 작업을 정교하게 예약하고 오케스트레이션할 수 있습니다.
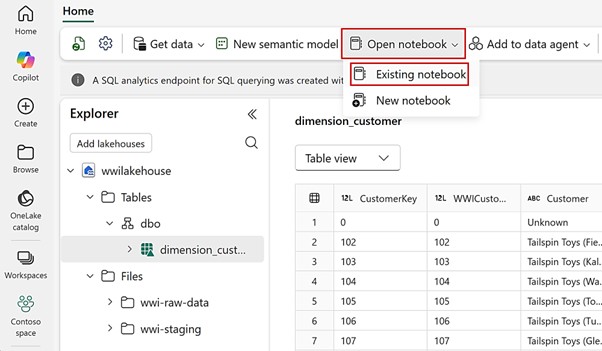 [그림 3] Fabric 환경 내의 레이크하우스(Lakehouse) 브라우저 및 데이터 엔지니어링을 위한 Notebook 연동 UI
좌측 탐색기(Explorer)에서 원레이크 카탈로그의 ‘wwilakehouse’에 접근하여 테이블(Tables)과 원천 파일(Files) 구조를 한눈에 볼 수 있으며, 상단의 ‘Open notebook’ 메뉴를 통해 기존 Notebook을 불러오거나 새 자바/파이썬 기반 Spark 코드를 즉시 구동할 수 있습니다.
| ③ Data Warehouse : 엔터프라이즈급 SQL 분석의 초격차 성능
업계 최고의 SQL 성능 및 규모를 제공합니다. 무엇보다 컴퓨팅(연산) 자원을 스토리지(저장소)와 완전히 분리하여 두 구성 요소의 독립적인 크기 조정(Scaling)을 가능하게 만듭니다. 이를 통해 비용을 최적화하는 동시에, 독점 포맷이 아닌 개방형 Delta Lake 형식으로 데이터를 안전하게 저장하여 뛰어난 개방성을 자랑합니다.
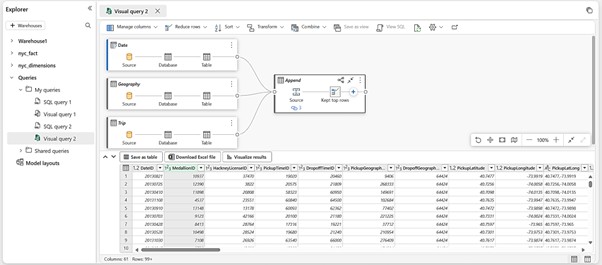 [그림 4] Data Warehouse의 시각적 쿼리 빌더(Visual Query) 및 고성능 SQL 분석 테이블 UI
SQL 구문에 익숙하지 않은 사용자라도 마우스 조작만으로 ‘Append(추가)’, ‘Filter(필터)’ 등 데이터 변환 흐름을 다이어그램 형태로 짤 수 있으며, 연산 결과는 하단 그리드 뷰를 통해 엑셀처럼 실시간으로 변환 데이터를 검증할 수 있습니다.
| ④ 패브릭 데이터 사이언스 : 비즈니스 예측을 위한 AI 모델 개발 환경
기업용 기계 학습(Machine Learning) 모델을 빌드, 배포 및 운영할 수 있는 환경으로, Azure Machine Learning과 유기적으로 통합되어 데이터 실험 추적 및 모델 레지스트리(저장소) 기능을 매끄럽게 제공합니다. 데이터 사이언스는 정교한 AI 예측 데이터로 조직의 원천 데이터를 보강할 수 있으며, 일반 비즈니스 분석가는 이러한 예측 수치를 Power BI 보고서에 연동함으로써 과거 분석(설명) 수준에 머물던 비즈니스 인사이트를 ‘미래 예측형(Predictive)’ 인사이트로 전환할 수 있습니다.
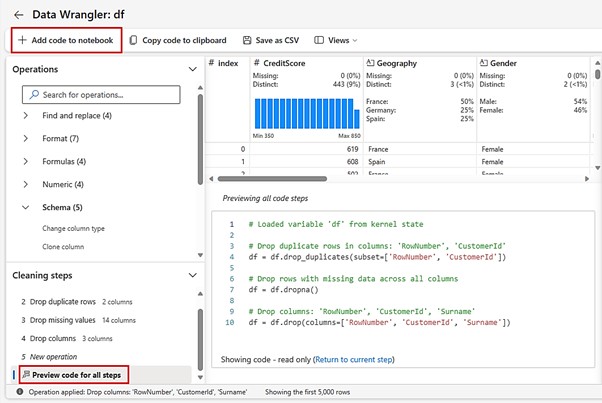 [그림 5] Data Wrangler를 활용한 데이터 정제(Data Cleaning) 과정
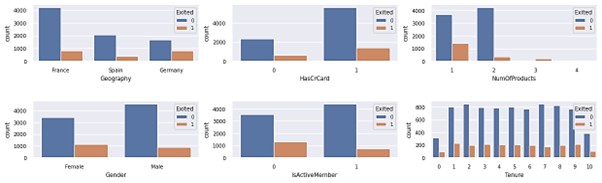 [그림 6] Data Wrangler를 활용한 머신러닝 시각화 차트 결과 화면
‘Data Wrangler’ 툴을 이용해 신용점수, 지역, 성별 등 고객 데이터를 분석할 때 발생하는 결측치 처리(Drop missing values), 중복 행 제거(Drop duplicate rows) 조작 작업을 코딩 없이 수행하면 자동으로 파이썬 코드가 생성됩니다. 하단에는 변수별 상관관계를 시각화한 분포 그래픽 차트가 자동으로 표시되어 분석의 정밀도를 높여줍니다.
| ⑤ Real-Time Intelligence : 지연 없는 실시간 스트리밍 분석
IoT(사물인터넷) 센서 판독 값, 서버 및 애플리케이션 로그, 웹사이트 클릭스트림(Clickstream)과 같이 끊임없이 쏟아지는 대용량 실시간 데이터를 도착 즉시 실시간으로 분석합니다. 실시간 데이터의 수집, 변환, 스토리지, 모델링, 분석, 시각화, 추적은 물론 AI 연동 및 작업 프로세스 자동화까지 한 번에 처리하여, 초 단위로 변동성이 높은 데이터로부터 비즈니스 기회와 인사이트, 액션을 신속하게 추출합니다.
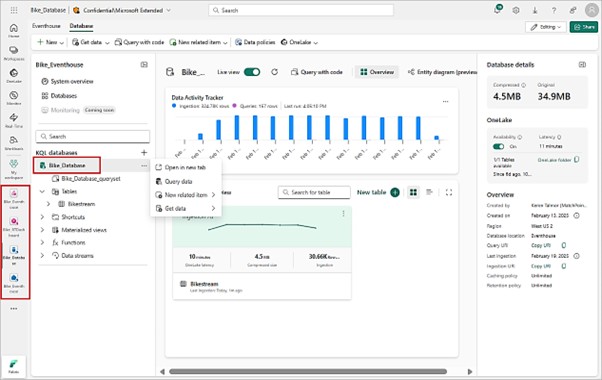
[그림 7] Real-Time Intelligence의 이벤트하우스(Eventhouse) 대시보드 및 실시간 데이터 활동 트래커 UI
초당 수십만 건씩 인입되는 데이터 활동 트래커(Data Activity Tracker)의 수집 및 쿼리 처리 현황을 실시간 바 차트로 모니터링할 수 있으며, 우측 속성창을 통해 압축률(4.5MB 압축으로 원본 34.9MB 대체)과 OneLake 가용성 등 데이터의 건강 상태를 실시간 관제할 수 있습니다.
| ⑥ Power BI : 데이터 이동이 필요 없는 초고속 비즈니스 시각화
사내외 다양한 데이터 원본에 실시간으로 연결하고, 대화형 차트와 대시보드를 생성하여 조직 전체에 실시간 비즈니스 인사이트를 공유할 수 있습니다. 현업 부서의 비즈니스 소유자는 Fabric의 강력한 아키텍처 덕분에 모든 전사 데이터에 빠르고 효과적으로 안전하게 액세스할 수 있으며 데이터 중심의 신속한 의사결정을 실현할 수 있습니다.
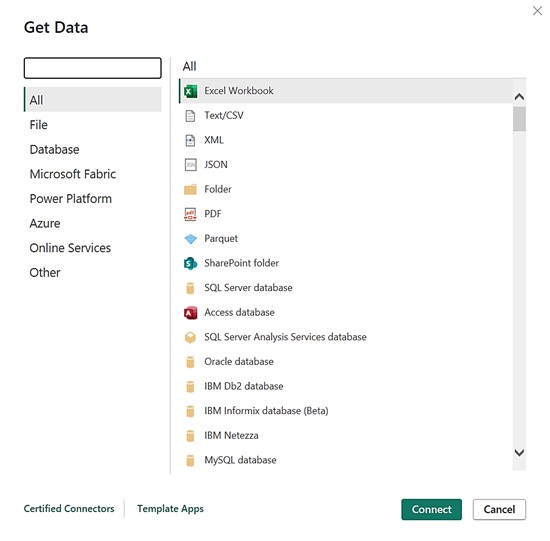
[그림 8] Power BI에서 다양한 온프레미스 및 클라우드 소스 데이터를 불러오는 ‘Get Data’ 커넥터 UI
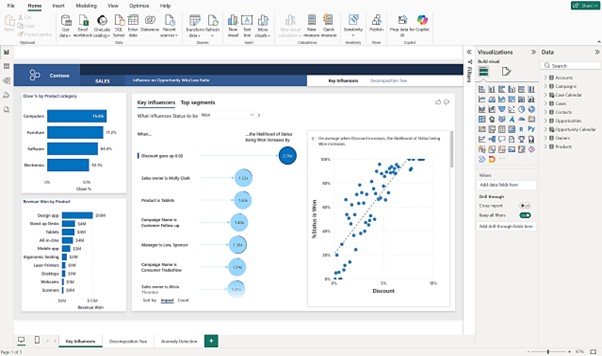
[그림 9] Power BI 보고서 구현
Excel 통합 문서, Text/CSV, XML, JSON 등 로컬 파일부터 SQL Server, Oracle, IBM DB2, MySQL 등 기업용 엔터프라이즈 DB 및 Microsoft Fabric 내부 자산까지 세상의 모든 데이터 소스를 단 몇 번의 클릭만으로 안전하게 당겨와 시각화할 수 있는 강력한 범용 인터페이스를 제공합니다.
| ⑦ IQ (미리 보기): 비즈니스 의미 체계 및 데이터 에이전트의 통합
데이터, 비즈니스 모델, IT 시스템 전반에서 유기적으로 작동하는 비즈니스 의미 체계(Semantic Meaning)를 일관되게 통합하기 위해 등장한 패브릭의 차세대 혁신 워크로드입니다. 온톨로지(Ontology), 실행 플랜, 패브릭 그래프, 데이터 에이전트(Data Agents), 작업 에이전트 및 의미 체계 모델의 다양한 항목이 유기적으로 포함됩니다. 이를 통해 전사 조직이 부서별로 서로 다른 기준을 쓰지 않고 일관된 의사결정을 내릴 수 있도록 돕고, 재사용 가능한 메트릭과 컨텍스트 인식 기반의 지능형 비즈니스 자동화를 지원합니다.
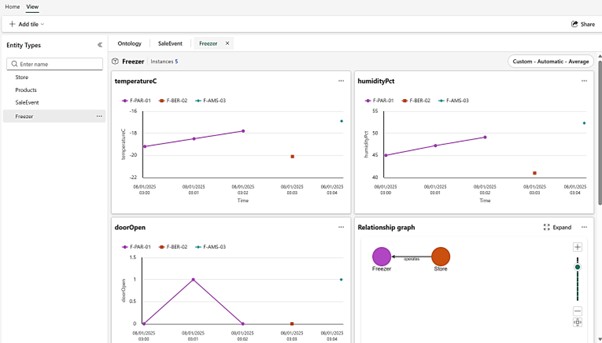
[그림 10] 차세대 워크로드인 IQ(미리 보기)의 온톨로지 정의, 관계 그래프(Relationship graph) 및 엔티티 트렌드 분석 UI
‘Store’, ‘Products’, ‘Freezer’ 등 기업이 관리하는 자산을 엔티티 타입으로 지정하고, 우측의 ‘Relationship graph’처럼 ‘Freezer(냉동고)는 Store(매장)에 의해 운영된다(operates)’와 같은 실제 비즈니스 도메인 논리를 시스템에 학습시킵니다. 이를 기반으로 온도 변동 추이나 그래프 같은 물리 데이터 분석에 지능형 컨텍스트를 결합해 줍니다.
우리 기업이 Microsoft Fabric을 도입해야 하는 이유
과거의 방식으로 구축된 데이터 인프라는 현재의 비즈니스 속도를 감당할 수 없습니다. 기업이 Microsoft Fabric으로 전환해야 하는 이유는 단순히 ‘새로운 기능’ 때문이 아니라, 기존 아키텍처가 가진 구조적 한계와 비용 손실을 차단하기 위함입니다. 그렇다면 많은 데이터 플랫폼 중에서 왜 Microsoft Fabric 일까요?
기업이 얻을 수 있는 실질적인 비즈니스 가치를 다음 3가지 관점으로 정리했습니다.
① 엔지니어링 생산성과 운영 효율성의 획기적 향상
-
통합 개발 환경 기반의 업무 효율 개선 : 기존 데이터 환경에서는 데이터 수집, 분석, 시각화, 머신러닝 작업마다 서로 다른 도구와 인터페이스를 오가야 했습니다. 이 과정에서 반복적인 로그인, 데이터 이동, 권한 설정 등의 비효율이 지속적으로 발생합니다. Microsoft Fabric은 단일 통합 환경에서 모든 데이터 워크로드를 처리할 수 있도록 설계되어 있어 불필요한 컨텍스트 전환(Context Switching)을 최소화합니다. 이를 통해 운영보다 분석과 가치 창출에 집중할 수 있습니다.
-
Copilot 기반 개발 속도 향상: Fabric에 내장된 Copilot은 자연어 기반으로 데이터 작업을 지원합니다. 예를 들어, “이 데이터에서 이상치를 탐지하는 SQL 쿼리를 생성해줘”와 같은 요청만으로도 복잡한 쿼리와 분석 로직을 자동 생성할 수 있습니다. 이를 통해 반복적인 개발 업무를 줄이고, 데이터 엔지니어와 분석가의 생산성을 크게 향상시킬 수 있습니다.
-
자동화 및 형상 관리: Fabric은 Git 통합과 협업 워크스페이스를 기본 지원합니다. 브랜치 관리, Pull Request(PR), CI/CD 기반 배포 프로세스 등 소프트웨어 개발 조직의 베스트 프랙티스를 데이터 플랫폼 운영에도 동일하게 적용할 수 있어 데이터 파이프라인의 안정성과 운영 일관성을 높일 수 있습니다.
② 진정한 의미의 ‘셀프 서비스 분석’ 실현
-
Direct Lake 기반의 실시간 초고속 분석 : 기존 BI 환경에서는 대용량 데이터를 분석하기 위해 별도의 데이터 Import 작업이나 복잡한 성능 튜닝이 필요했습니다. Microsoft Fabric의 Direct Lake 기술은 OneLake에 저장된 데이터를 직접 분석할 수 있도록 지원합니다. 데이터 복제 없이도 대규모 데이터를 실시간에 가까운 속도로 시각화할 수 있기 때문에 분석 민첩성과 사용자 경험을 동시에 향상시킬 수 있습니다.
-
No-Code / Low-Code 기반 데이터 활용 확대 : Fabric은 Dataflows 기반의 No-Code·Low-Code 환경을 제공해 현업 사용자도 직접 데이터 파이프라인을 구성하고 필요한 데이터를 활용할 수 있도록 지원합니다. 이를 통해 IT 부서 의존도를 낮추고, 데이터 기반 의사결정 문화를 조직 전반으로 확산시킬 수 있습니다.
-
중앙 집중형 거버넌스와 보안 체계 강화 : 데이터 활용이 확대될수록 보안과 거버넌스 체계는 더욱 중요해집니다. Fabric은 중앙에서 데이터 민감도 레이블(Sensitivity Label), 접근 권한, 데이터 손실 방지(DLP) 정책을 통합 관리할 수 있도록 지원합니다. 즉, 데이터 자율성과 보안 통제를 동시에 확보할 수 있는 구조를 제공합니다.
③ AI 시대를 위한 확장성과 미래 대응 역량 확보
-
AI/ML 워크플로우 통합 지원: Microsoft Fabric은 Notebook 환경과 MLflow를 통합 지원하여 데이터 준비부터 모델 학습, 배포, 모니터링까지 AI·ML 전 과정을 하나의 플랫폼에서 운영할 수 있도록 지원합니다. 이를 통해 기업은 예측 분석, 추천 시스템, 생성형 AI 기반 서비스 등 AI 중심 비즈니스를 보다 빠르게 구현할 수 있습니다.
-
개방형 표준 기반의 유연한 데이터 아키텍처 : Fabric은 데이터를 특정 벤더의 독점 포맷이 아닌 Delta Parquet 기반의 개방형 표준 포맷으로 저장합니다. 이를 통해 멀티 클라우드 환경이나 외부 시스템과의 연계 유연성을 확보할 수 있으며, 장기적으로 벤더 종속성(Vendor Lock-in) 리스크를 줄일 수 있습니다.
-
탄력적(Elastic) 컴퓨팅 기반 비용 최적화 : Fabric은 워크로드별 리소스를 유연하게 분리·확장할 수 있는 Elastic 컴퓨팅 구조를 제공합니다. 피크 시간대에는 필요한 만큼 성능을 확장하고, 사용량이 적은 시간에는 리소스를 효율적으로 축소함으로써 데이터 인프라 운영 비용을 최적화할 수 있습니다.

Microsoft Fabric은 단순한 데이터 분석 도구가 아닙니다.
이는 기업 내에 분산된 데이터를 어떻게 통합하고, 안전하게 관리하며, 실질적인 비즈니스 가치로 연결할 것인지에 대한 새로운 데이터 운영 프레임워크입니다.
OneLake 기반의 데이터 통합 구조, SaaS 기반의 운영 효율성, 그리고 Copilot 중심의 AI 기능을 통해 기업의 데이터는 단순한 저장 자산을 넘어 비즈니스 성장을 주도하는 전략 자산으로 진화할 수 있습니다.
특히 AI 전환(AI Transformation)이 가속화되는 현재, 데이터 플랫폼의 경쟁력은 곧 기업 경쟁력과 직결됩니다. Microsoft Fabric을 선제적으로 도입하는 기업은 데이터를 단순한 운영 기록이 아닌, 미래 비즈니스를 이끄는 핵심 자산이자 새로운 수익 창출 기반으로 활용하게 될 것입니다.
데이터 플랫폼 혁신과 AI 기반 비즈니스 전환을 고민하고 있다면, 지금이 바로 Microsoft Fabric을 검토해야 할 시점입니다.
클라우드 전문기업 GowIT는
기업 환경에 최적화된 클라우드 서비스와
GowIT 고객사를 위한 차별화된 기술지원 서비스를 제공합니다.
서비스 문의
02-462-5365 / gocloud@gowit.co.kr
https://cloud.gowit.co.kr